Сайт открывается в браузере, индексируется Google, возвращает 200 OK на любой чекер — а ChatGPT, Perplexity и Claude получают вместо страницы — капчу. В одном из наших аудитов Common Crawl фиксировал ~91% страниц со статусом 200, а AI-боты в live-тесте получили полезный HTML в 17% попыток. Мы разобрали, почему стандартные способы проверки не видят эту проблему, и показываем методологию, которая работает.
Исследовательский отдел moab проводит аудиты AI-видимости с 2025 года. За это время методология прошла четыре итерации — от curl с одним User-Agent до матричного тестирования по комбинациям URL × бот × IP-сценарий × повторная попытка. Ниже — эволюция метода, обезличенные кейсы из реальных аудитов и конкретные инструменты, чтобы проверить свой сайт самостоятельно.
Конвейер AI-видимости: доступность → структура → контент → мониторинг
Как обычно проверяют AI-видимость и где каждый способ обманывает
Матрица: URL × бот × IP × две попытки
Три кейса: неравномерный доступ, массовая блокировка, полная доступность
Управление доступом — не клоакинг
Порядок работ: доступность первична
Главная мысль
Коротко о главном
-
HTTP-статус 200 OK не гарантирует доступность для AI-ботов: сервер может вернуть HTML капчи, антибот-шаблон или пустой SPA-каркас с тем же кодом ответа — и чекер отметит страницу как доступную.
-
robots.txt — декларация для бота, а не команда для CDN: файл может разрешать доступ, а WAF/антибот все равно отдаст капчу.
-
Антибот бьет неравномерно: в одном из аудитов информационные страницы были открыты, а коммерческое ядро — каталоги, карточки, калькуляторы — закрыты. AI-модель может рассказать о статьях бренда, но не увидит страницы, которые приводят к заявкам.
-
Common Crawl может показывать ~91% доступности, а AI-боты в live-тесте того же сайта — получить корректный HTML в 17% попыток.
-
География IP дала минимальную разницу: 107 из 456 попыток с российских IP против 106 из 456 с иностранных. Проблема — в логике антибота, а не в геолокации.
-
Инференс-боты (ChatGPT-User, Perplexity-User, Claude-User) и краулеры (GPTBot, CCBot, ClaudeBot) решают разные задачи: одинаково управлять доступом для них — ошибка.
-
Методология основана на User-Agent-тестировании и не имитирует верифицированных ботов с официальных IP. Она показывает риск и фактическую реакцию сайта в контролируемом тесте, а не абсолютную картину.
-
Команды для быстрой проверки и чек-лист порядка работ — в статье.
Конвейер AI-видимости: доступность → структура → контент → мониторинг
AI-видимость сайта раскладывается на четыре звена, и выдать ошибку она может на каждом из них. Первое звено — физическая доступность: получил ли бот содержательный HTML, а не капчу или пустой шаблон. Второе — структура: есть ли на странице schema.org, мета-данные и семантическая разметка, которую модель может интерпретировать. Третье — контент: отвечает ли текст на интент пользователя, есть ли E-E-A-T-сигналы, FAQ, таблицы сравнений. Четвертое — мониторинг: появляется ли сайт в ответах ChatGPT, Perplexity, AI Overviews и с какой частотой.
Большинство гайдов по AEO/GEO начинают со второго или третьего звена — оптимизации контента, добавления FAQ, разметки schema.org. Но если первое звено сломано и бот вместо страницы получает SmartCaptcha, Cloudflare challenge или пустой SPA-каркас, все улучшения второго и третьего звена остаются невидимыми. Поэтому все наши аудиты начинаются с доступности.
Как обычно проверяют AI-видимость и где каждый способ обманывает
Прежде чем показать нашу методологию, разберем пять способов, которые используются чаще всего, и покажем конкретную точку ошибки каждого. Каждый из них — полезен на своем уровне.
robots.txt: разрешение есть, доступа нет
Проверка обычно начинается с robots.txt: есть ли там запреты или разрешения для GPTBot, ClaudeBot, CCBot, PerplexityBot, OAI-SearchBot и других User-Agent. Это полезно — и это первое, на что стоит смотреть. Но robots.txt показывает только намерение владельца сайта. Проблема в том, что robots.txt и CDN/WAF — это два независимых слоя, которые ничего не знают друг о друге.
robots.txt — инструкция для бота: «тебе сюда можно» или «тебе сюда нельзя». Но CDN/WAF-защита работает на другом уровне: она смотрит не на robots.txt, а на заголовки запроса, IP-адрес, ASN (какой сети принадлежит IP), частоту обращений, репутацию источника и поведенческие паттерны. Решение о допуске или блокировке CDN принимает независимо от того, что написано в robots.txt.
В результате возникает типичная ситуация из наших аудитов: robots.txt содержит Allow: / для GPTBot и ClaudeBot, технический SEO-специалист уверен, что доступ настроен, а AI-бот при обращении к коммерческой странице получает SmartCaptcha — потому что WAF классифицировал запрос как подозрительный по совокупности признаков. Зеркальная ситуация тоже встречается: robots.txt не содержит явного запрета, но сервер реагирует на конкретный User-Agent как на нежелательный трафик.
Отсюда правило: robots.txt проверять нужно, но считать его гарантией доступа — ошибка.
HTTP-статус: 200 OK с капчей внутри
Для SEO проверка статус-кода — привычный рефлекс: 200 — все хорошо, 403 — заблокировано, 301 — редирект. С этого начинались и наши первые проверки: мы отправляли запросы через curl с нужным User-Agent и сохраняли HTML в файл, чтобы затем посмотреть, что вернул сервер:
curl -s -A "Mozilla/5.0 (compatible; GPTBot/1.0)" -o test.html https://site.ru/
Затем масштабировали подход на несколько страниц и нескольких ботов: главная, блог, коммерческие разделы, страницы решений и сервисов. Именно на этом этапе стало понятно, что сам факт сохраненного HTML-файла ничего не значит без анализа его содержимого.
В одном из ранних тестов мы сохранили HTML-ответ и увидели файл размером около 13 КБ — при том, что содержательная страница обычно весит 50–200 КБ. HTTP-статус — 200. Но внутри — не страница сайта, а HTML капчи: title «Are you not a robot?», маркеры Yandex SmartCaptcha, код Яндекс.Метрики и JavaScript-проверка. Если смотреть только на статус-код, такой ответ легко принять за успешную загрузку. Если открыть файл и посмотреть на title и размер — видно, что бот получил не контент, а защитный экран.
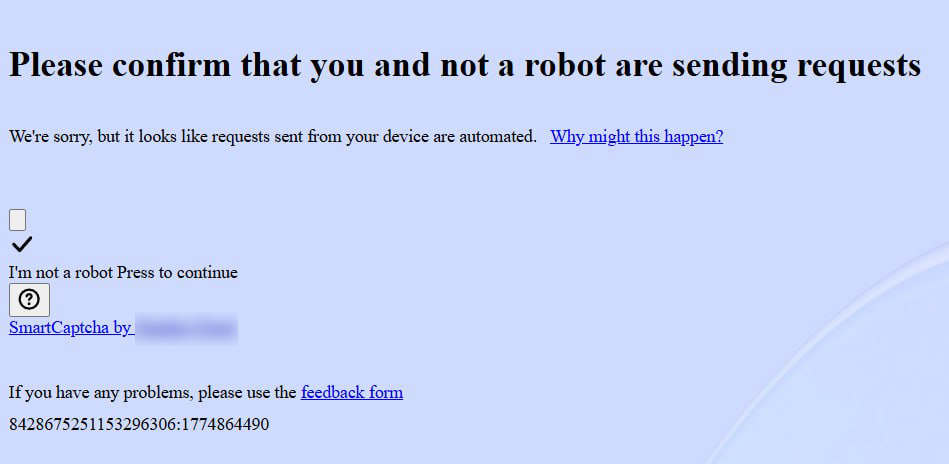
Так появляется ложноположительный результат: инструмент пишет «200 OK, страница доступна», а фактически бот получил экран «Вы не робот?» Для AI-видимости это практически равно блокировке — модель не может использовать капчу в ответе пользователю. Отсюда правило, которое легло в основу нашей методологии: проверять не факт ответа, а его содержимое. AI-боту нужен не статус-код, а содержательный HTML: текст, ссылки, метаданные, structured data, карточки, цены, описания, FAQ.
При этом важно понимать ограничение самого метода проверки. User-Agent — это строка в заголовке запроса, и подставить ее может кто угодно. Серьезные антибот-системы это знают и смотрят не только на User-Agent, а на совокупность признаков:
-
IP-адрес и его ASN (принадлежность к сети провайдера),
-
reverse DNS-запись (подтверждает ли она, что IP принадлежит OpenAI, Anthropic или другому провайдеру бота),
-
TLS-fingerprint — цифровой «отпечаток» TLS-соединения, по которому можно отличить браузер от скрипта,
-
частоту запросов и поведенческие паттерны.
Поэтому тест с подставленным User-Agent — не абсолютная имитация настоящего верифицированного бота. Настоящий GPTBot, приходящий с официального IP-диапазона OpenAI и проходящий reverse DNS-проверку, может получить другой ответ. Но это не делает проверку бесполезной — она показывает риск: как сайт реагирует на заявленные AI User-Agent в контролируемых условиях, где возникают капчи и нестабильность, какие разделы закрываются защитой. А обнаруженные проблемы дальше верифицируются в логах CDN/WAF, где видно, как сервер отвечал настоящим ботам с официальных IP.
Мы регулярно видим в аудитах одну и ту же ситуацию: robots.txt разрешает доступ, технический SEO-специалист уверен, что все настроено, а AI-боты получают капчу. Разрыв между декларацией в robots.txt и фактической реакцией CDN/WAF — пожалуй, самый частый источник ложной уверенности, что «у нас с AI-видимостью все ок».
© Александра Ламонова, Senior SEO, специалист по GEO-оптимизации, moab
Готовые чекеры: бинарный ответ на небинарный вопрос
Третий способ — готовые онлайн-чекеры AI-видимости. Обычно они проверяют robots.txt, HTTP-статус и иногда заголовки ответа. Но редко понятно, анализируют ли они тело ответа, размер HTML, признаки капчи, стабильность между попытками и разницу между IP-адресами.
Главная проблема чекеров — бинарность результата: «доступно» или «заблокировано». Реальность устроена сложнее, и наши аудиты это показывают постоянно. Страница может быть доступна для одного бота и закрыта для другого — в travel-кейсе, который мы разберем ниже, лишь часть комбинаций страница × бот отдавала контент, а большинство — капчу. Страница может быть доступна с одного IP и закрыта с другого. Страница может быть доступна при первом запросе и закрыта при втором — когда антибот работает не по whitelist/blacklist, а по частоте запросов.
В одном из ранних тестов мы увидели это буквально: один User-Agent получил контент на большинстве страниц в первом раунде, а во втором — почти везде капчу. Антибот-система не блокировала бота постоянно, а срабатывала по накопленной репутации сессии. Чекер, проверяющий один раз, покажет «доступно». Повторная проверка через минуту — «заблокировано». Какой результат правильный? Оба — и ни один.
Анализ полезности Cloudflare-чекера для измерения AI-машиночитаемости сайтов мы делали ранее.
Common Crawl: краулер видит — инференс-бот нет
Четвертый способ — посмотреть Common Crawl или другие внешние индексы. Это помогает понять, попадает ли домен в большие краулинговые датасеты. Но здесь работает подмена: Common Crawl проверяет доступность для CCBot — краулера, который собирает данные для индекса. А ChatGPT-User, Perplexity-User или Claude-User — это инференс-боты, которые приходят в момент пользовательского запроса. Разные боты, разные IP-диапазоны, разные паттерны запросов — и разная реакция антибот-систем.
В одном из наших аудитов Common Crawl показывал ~91% страниц со статусом 200, а AI-боты в live-тесте получили корректный HTML примерно в 17% попыток. Common Crawl при этом не бесполезен — он подтверждает, что сайт в целом краулится. Но это не доказывает, что инференс-боты смогут получить коммерческий HTML в момент пользовательского запроса. А именно этот момент определяет, попадет ли сайт в ответ AI-ассистента.
Промпт-мониторинг: симптом без диагноза
Пятый способ — мониторить ответы ChatGPT, Perplexity и другие AI-сервисы по набору промптов: упоминается ли сайт, цитируются ли страницы, ставятся ли ссылки. Это важная практика, и мы рекомендуем ее как часть регулярного мониторинга, но она проверяет симптом, а не причину.
Допустим, вы мониторите 50 промптов, релевантных вашему бизнесу, и видите, что сайт не появляется в ответах. Причин может быть как минимум пять: проблема в контенте (недостаточно релевантен или авторитетен), проблема в индексации (модель не знает о существовании страницы), проблема в robots.txt (бот не имеет права обращаться к странице), проблема в антиботе (бот получает капчу вместо контента), или модель просто не выбрала ваш сайт среди конкурентов. Без технического аудита доступности вы не можете отличить одну причину от другой — а значит, не знаете, что чинить.
Промпт-мониторинг работает как индикатор на приборной панели: он показывает, что что-то не так, но не говорит, где именно ломается конвейер. Для диагностики нужно спуститься на уровень ниже — к тому, какой HTML фактически получает бот.
Быстрый тест. Отправьте curl с User-Agent AI-бота на свою ключевую коммерческую страницу (не на главную — антибот часто бьет неравномерно):curl -s -A "Mozilla/5.0 (compatible; GPTBot/1.0)" -o test.html https://yoursite.ru/catalog/
Откройте test.html в текстовом редакторе или браузере. Три маркера проблемы: (1) title содержит «captcha», «challenge», «robot», «verify» или название защитной системы; (2) размер файла 10–15 КБ вместо ожидаемых 50–200 КБ — проверьте командой ls -la test.html; (3) нет коммерческого контента — только скрипты, JavaScript-проверки и заглушка. Если сработал хотя бы один — у вас проблема на первом звене конвейера, и никакая GEO-оптимизация ее не решит.
Следующий шаг — повторить тест для 2–3 других User-Agent (ChatGPT-User, ClaudeBot, PerplexityBot) и для 2–3 разных типов страниц (каталог, карточка, блог), чтобы увидеть, бьет ли антибот равномерно или точечно.
Матрица: URL × бот × IP × две попытки
Когда стандартные способы перестали давать полную картину, мы перестроили методологию с нуля. Ключевой сдвиг — с вопроса «ответил ли сервер?» на вопрос «получил ли AI-бот полезный HTML?».
Что входит в матрицу
Аудит проверяет набор URL по нескольким осям: тип страницы, тип бота, сетевой сценарий, две последовательные попытки.
В список URL входят не только главные страницы, но и коммерческие разделы: каталоги, карточки товаров или объектов, категории, листинги, калькуляторы, страницы с ценами. Отдельно — информационные страницы: блог, журнал, FAQ, гайды. Отдельно — технические URL: robots.txt, sitemap.xml, страницы ошибок. Антибот-защита часто работает неравномерно, и разница между информационным и коммерческим разделами — одна из самых частых находок наших аудитов.
Ботов мы разделяем по назначению на инференс-ботов (ChatGPT-User, OAI-SearchBot, Perplexity-User, Claude-User, DuckAssistBot) и краулеров (GPTBot, ClaudeBot, CCBot, Google-Extended, DeepSeekBot, Bingbot). Для каждой пары URL × бот делаем две попытки — это минимум, чтобы увидеть разницу между стабильным whitelist/blacklist и rate-based срабатыванием.
Что анализируем в ответе
HTTP-статус — только входная точка. Дальше мы смотрим тело ответа: есть ли полезный HTML с текстовым контентом, не отдана ли капча или антибот-страница, нет ли редиректа на защитный сценарий, какой размер ответа (капча обычно 10–15 КБ, содержательная страница — 50–200+ КБ), стабилен ли результат между двумя попытками, сохранились ли structured data (schema.org), как отличается поведение в разных IP-сценариях.
На выходе — классификация каждой пары:
|
Статус |
Что это значит |
|
OK |
Бот получил полезный HTML с содержательным контентом |
|
CAP |
Бот получил капчу или антибот-страницу |
|
SPA |
Бот получил каркас одностраничного приложения: HTML технически есть, но контент рендерится JavaScript на стороне клиента — без исполнения JS страница пуста |
|
REDIR |
Ответ закончился редиректом, который не привел к содержательной странице — цепочка ссылок, петля или уход на служебный URL |
|
ERR |
Ошибка, пустой ответ или неожиданный формат |
|
Смешанная пара |
Первая и вторая попытки дали разный результат — признак нестабильности |
Таблица читается по колонке «Статус»: OK — единственный результат, при котором AI-бот может использовать страницу. Все остальное — потеря видимости. Это базовые классы — на тепловых картах конкретных аудитов набор зависит от того, что фактически возвращал сайт.
IP-сценарии
Позже мы добавили сравнение сетевых сценариев: запросы с российского IP и с иностранного IP через прокси. Антибот-системы могут реагировать не только на User-Agent, но и на географию, ASN, репутацию IP-диапазона и сетевое окружение. Два IP-сценария — минимальный набор, чтобы увидеть, влияет ли география на реакцию сервера.
Ограничения метода
Метод основан на подстановке User-Agent, а не на запросах с официальных IP-диапазонов провайдеров ботов. Настоящий GPTBot приходит с IP, принадлежащих OpenAI, и проходит reverse DNS-верификацию — наш тест это не имитирует. Результат показывает, как сайт реагирует на заявленные AI User-Agent в контролируемых условиях, — это индикатор риска, а не абсолютная картина. Обнаруженные проблемы дальше проверяются в логах CDN/WAF и при необходимости через запросы с верифицированных IP.
Быстрый тест: минимальная матрица своими руками. Возьмите три страницы (главная, одна коммерческая, одна информационная) и три бота (GPTBot, ChatGPT-User, ClaudeBot). Для каждой пары отправьте два запроса через curl с соответствующим User-Agent и сохраните HTML:
curl -s -A "Mozilla/5.0 (compatible; GPTBot/1.0)" -o test_gptbot_1.html https://yoursite.ru/catalog/
curl -s -A "Mozilla/5.0 (compatible; GPTBot/1.0)" -o test_gptbot_2.html https://yoursite.ru/catalog/
Для каждого файла проверьте: (1) размер — ls -la test_*.html; (2) title — grep -i '<title>' test_*.html; (3) наличие коммерческого контента — откройте в браузере. Если среди 18 файлов (3 страницы × 3 бота × 2 попытки) хотя бы один содержит капчу или пустой шаблон — это сигнал для полноценного аудита.
Три кейса: неравномерный доступ, массовая блокировка, полная доступность
Три аудита из нашей практики иллюстрируют три разных картины: от частичной блокировки до полной доступности. Ниже — отраслевые характеристики без названий брендов и доменов.
Кейс 1. Недвижимость: журнал виден, коммерческое ядро закрыто
Крупный сервис недвижимости — тысячи страниц каталога, карточек объектов, новостроек, аренды, ипотеки, калькуляторов. Плюс информационный журнал с десятками статей.
Матрица показала неравномерную картину. Информационные страницы (особенно журнал-раздел) в целом отдавали корректный HTML. А коммерческие разделы (каталоги, карточки объектов, новостройки, аренда, ипотека, калькуляторы) часто закрывались защитой.
Цифры: с российских IP корректный HTML получен в 107 из 456 попыток, то есть примерно в 23,5% случаев. С иностранного IP — 106 из 456, около 23,2%.
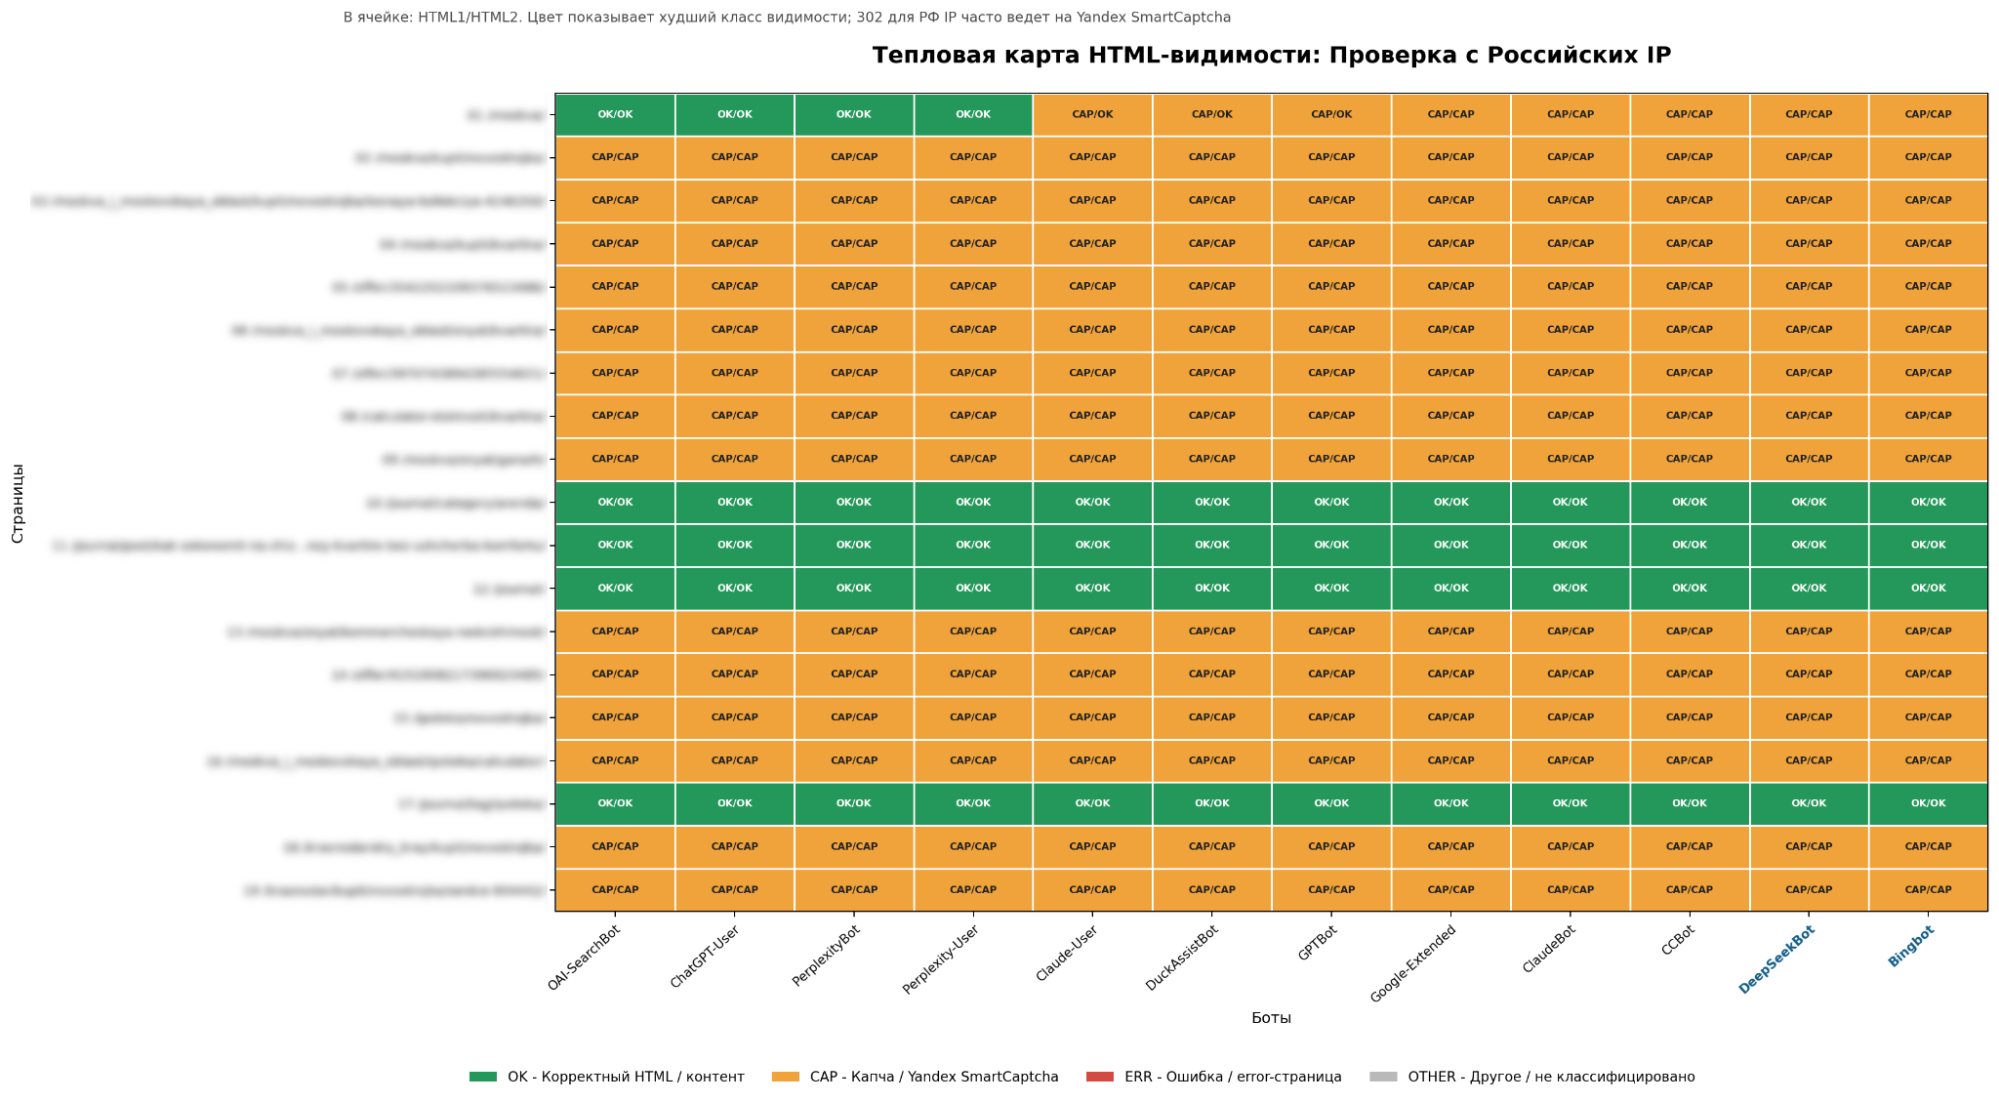
Мы ожидали увидеть разницу по географии, а ее не оказалось. Одна попытка из 456 — статистическая погрешность. Проблема не в том, откуда приходит запрос, а в том, на какие URL и User-Agent реагирует антибот.
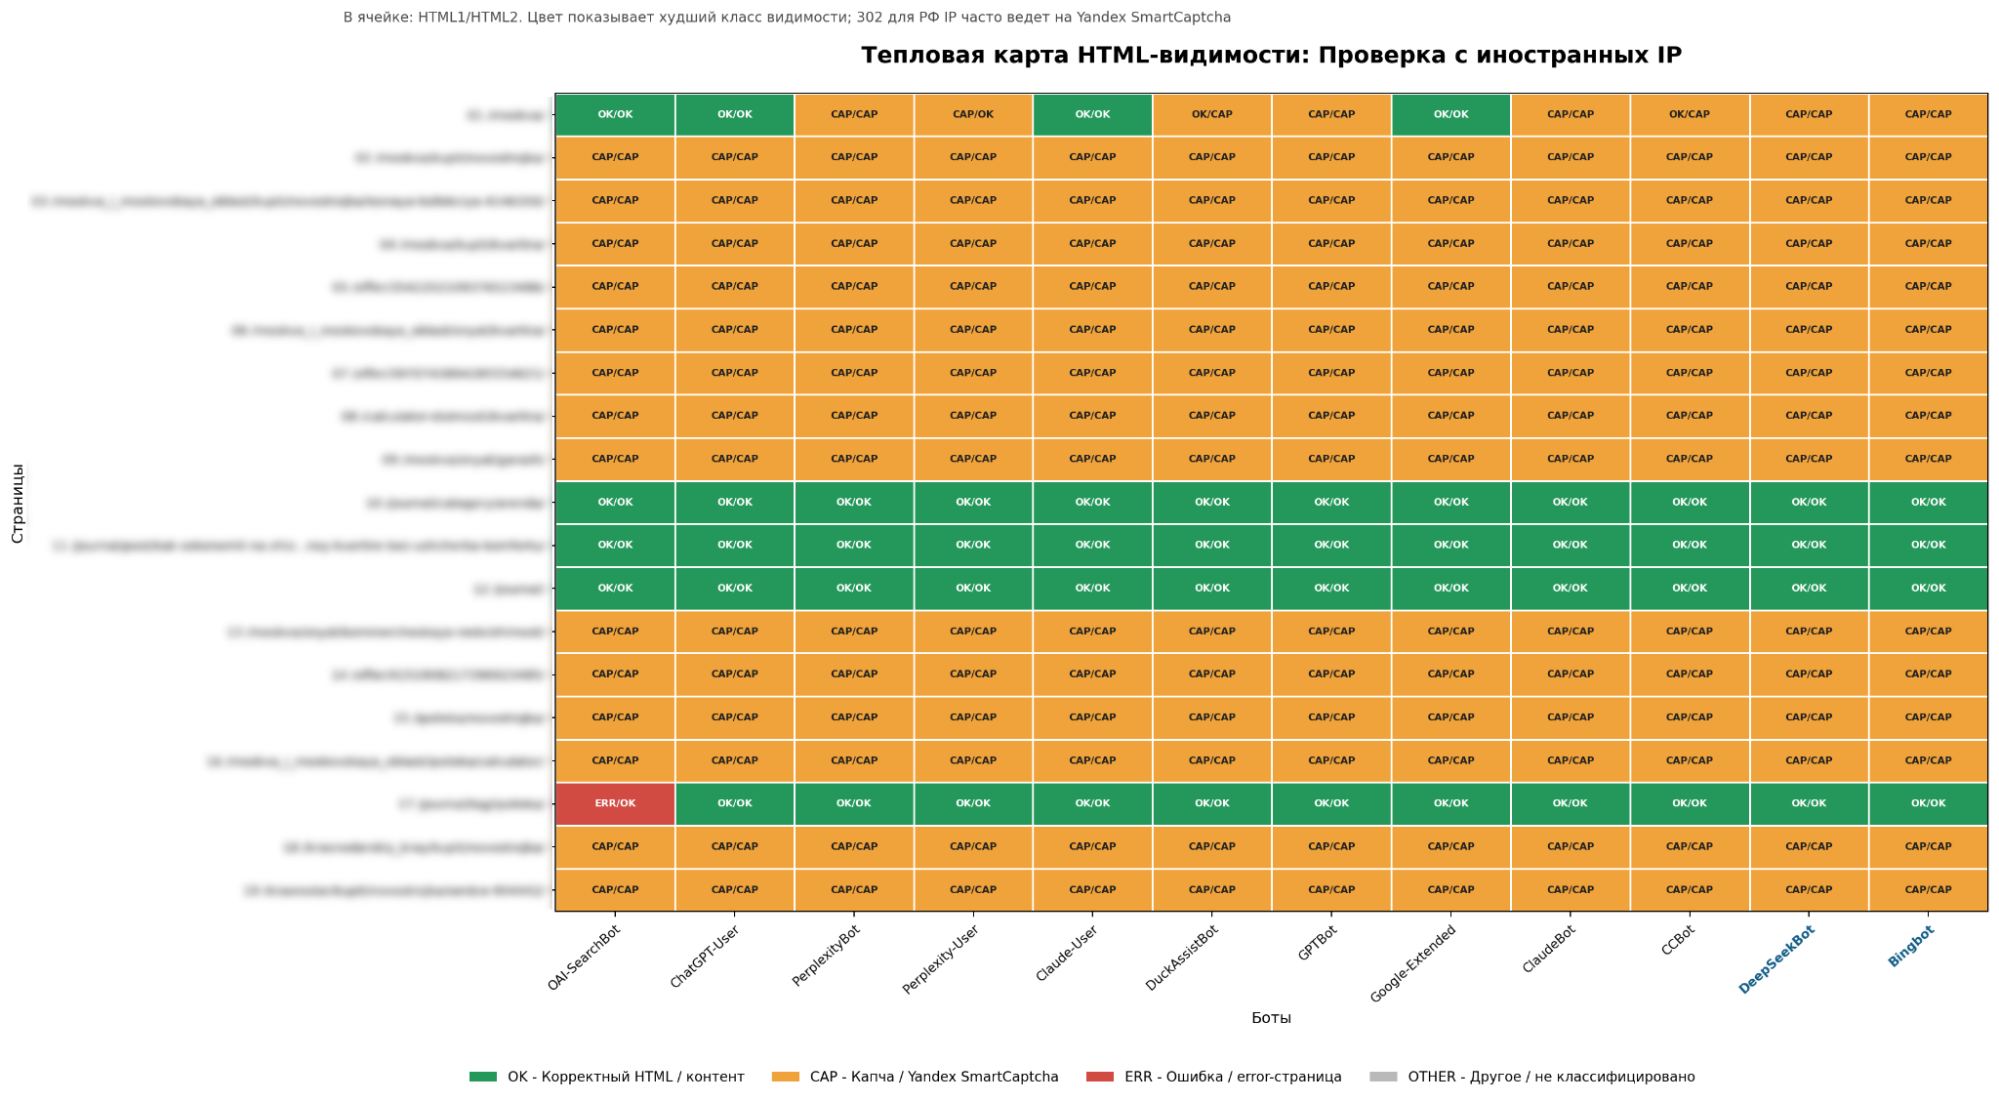
Для бизнеса это критичная ситуация, которая не видна ни в стандартных чекерах, ни в промпт-мониторинге, ни в Common Crawl. AI-модель может рассказать о статьях бренда — потому что журнал доступен. Но она не увидит страницы, которые приводят к заявкам и сделкам: каталог, карточки объектов, цены. Сайт «полувидим»: его контентная оболочка доступна, а коммерческое ядро — нет.
На практике: если ваш сайт сочетает информационный и коммерческий разделы (а это большинство крупных e-com и сервисных сайтов), проверяйте оба раздела отдельно. Тест на одной странице не покажет полную картину: главная страница и блог могут быть открыты, а каталог — закрыт.
Кейс 2. Travel: 91% здоровья в Common Crawl — и 17% реального доступа
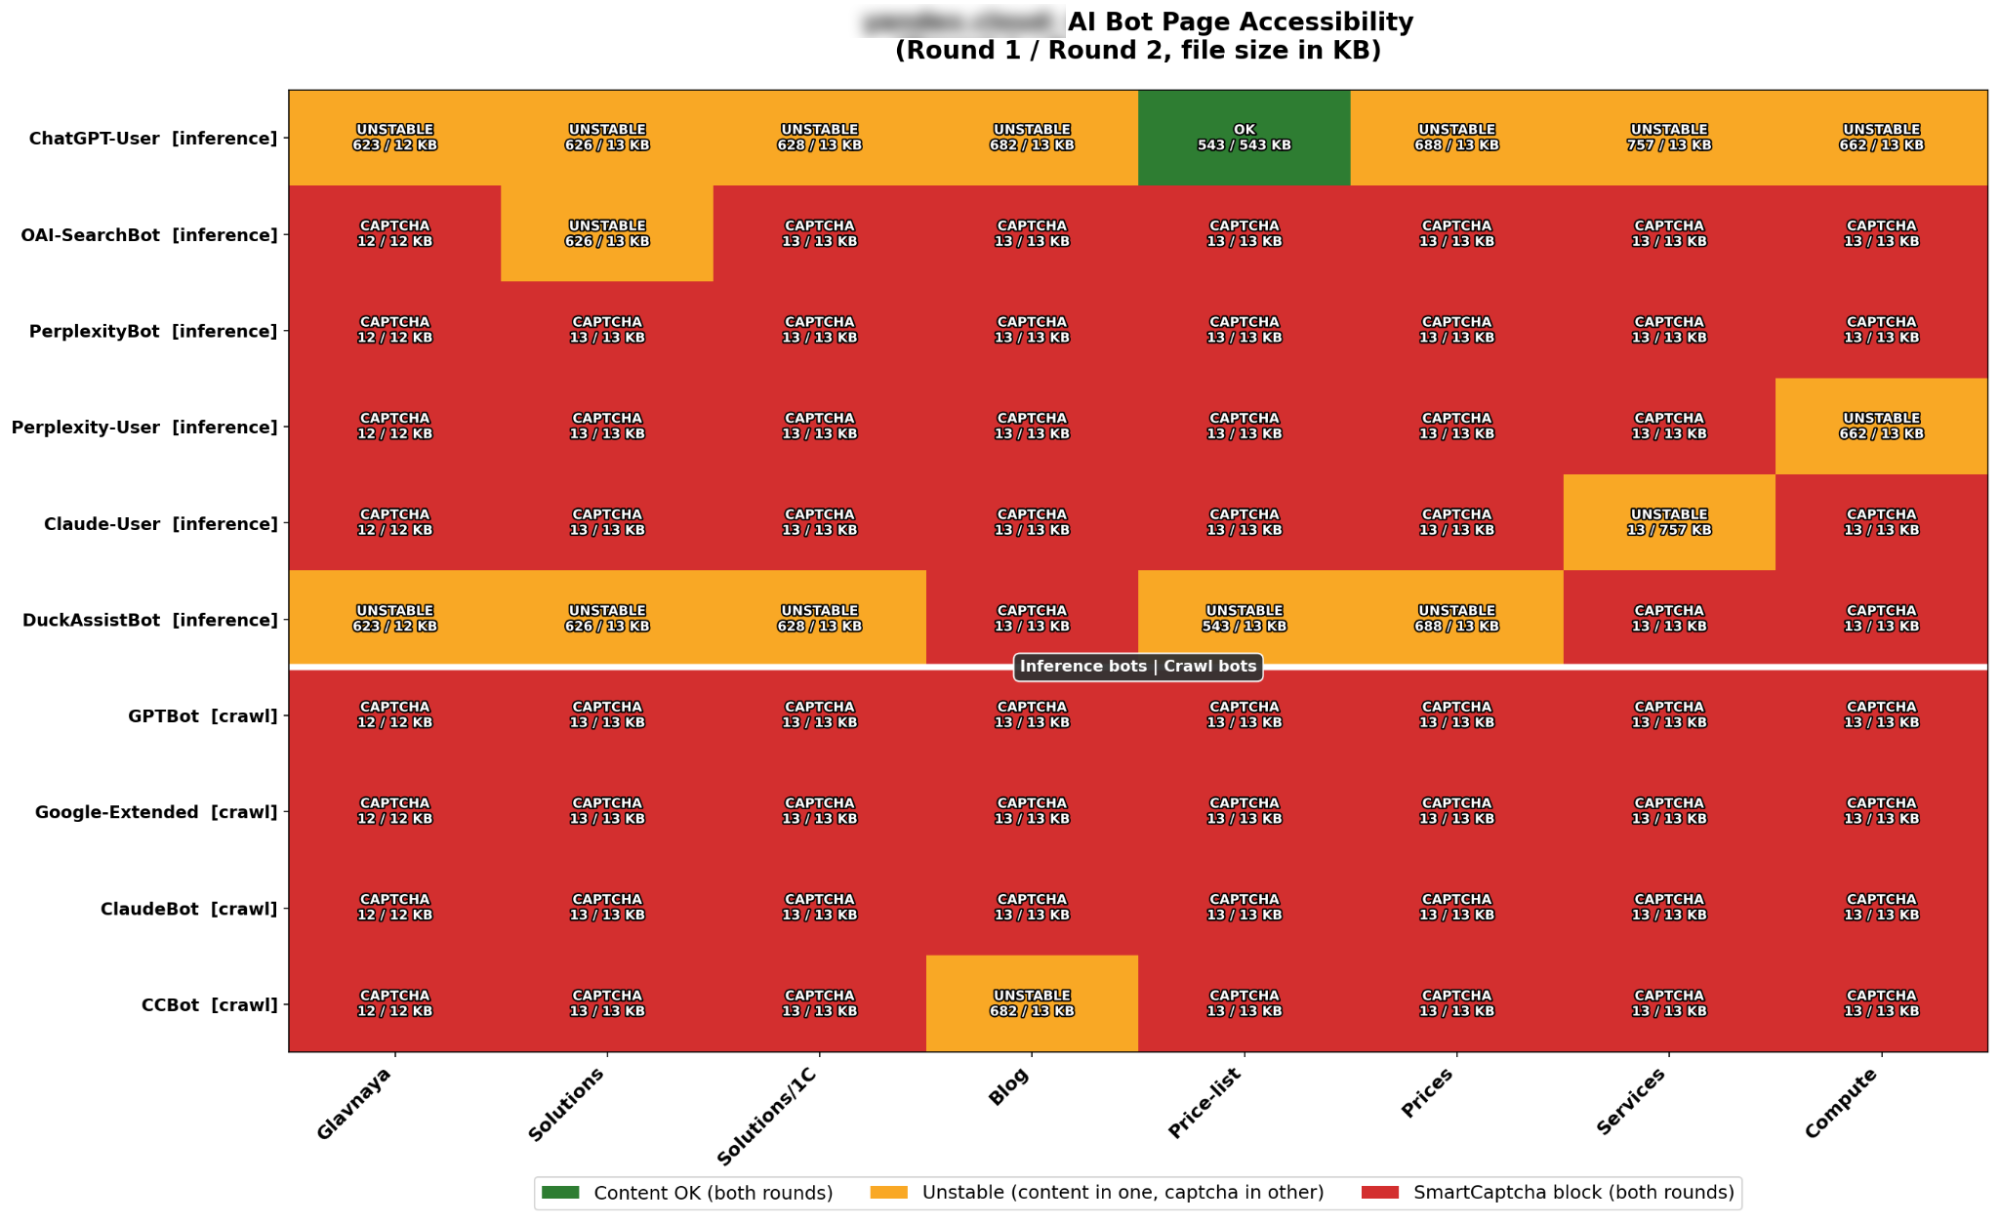
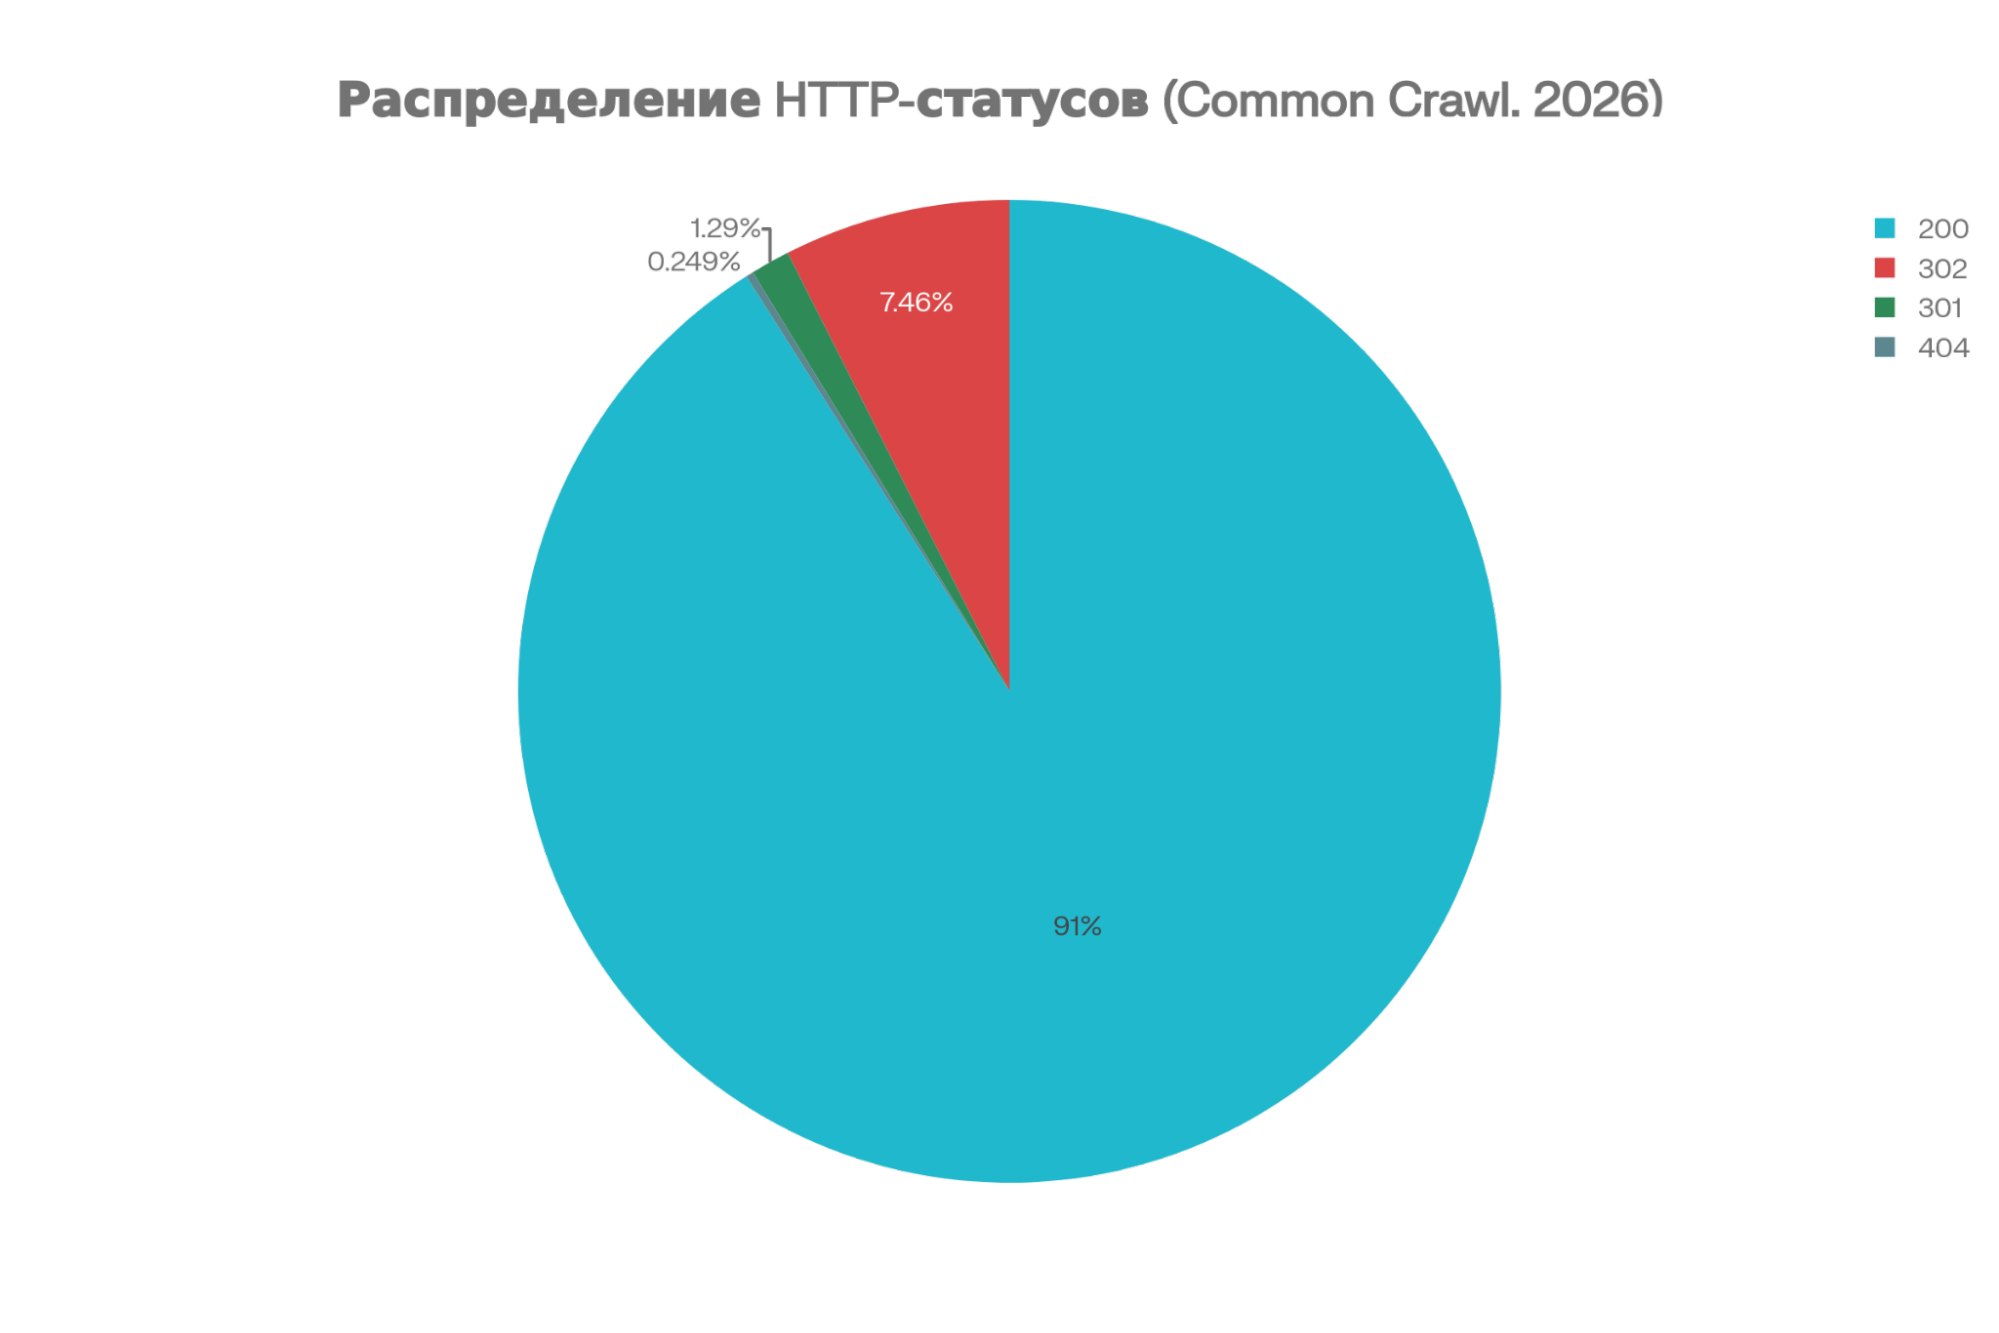
Travel-сервис с десятками тысяч страниц. Мы проверили 144 комбинации: 12 страниц × 12 ботов. Корректный HTML получен только в 25 случаях — около 17%. Капча — в 112 случаях, около 77%. Оставшиеся 7 комбинаций (около 5%) — редиректы и ошибки.
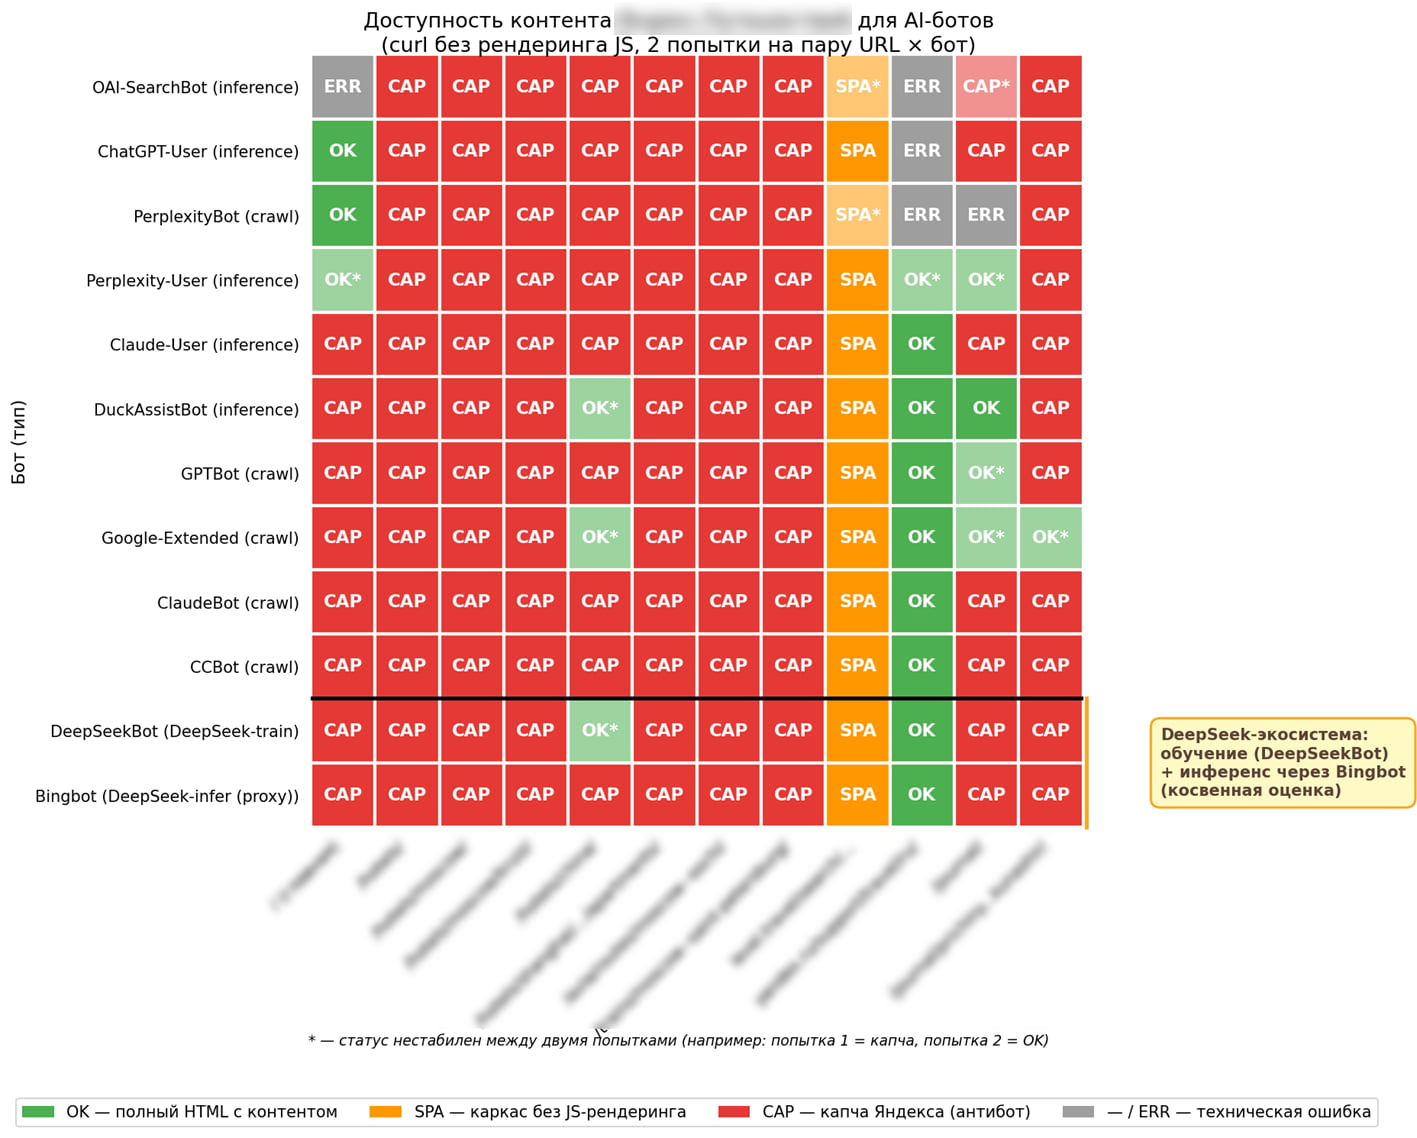
При этом стабильность между двумя попытками была высокой: 132 из 144 комбинаций (91%) дали одинаковый результат в обоих раундах. Проблема не выглядела случайной — сайт последовательно отдавал защиту значительной части AI User-Agent. Это не rate-based срабатывание, а устойчивая политика антибота.
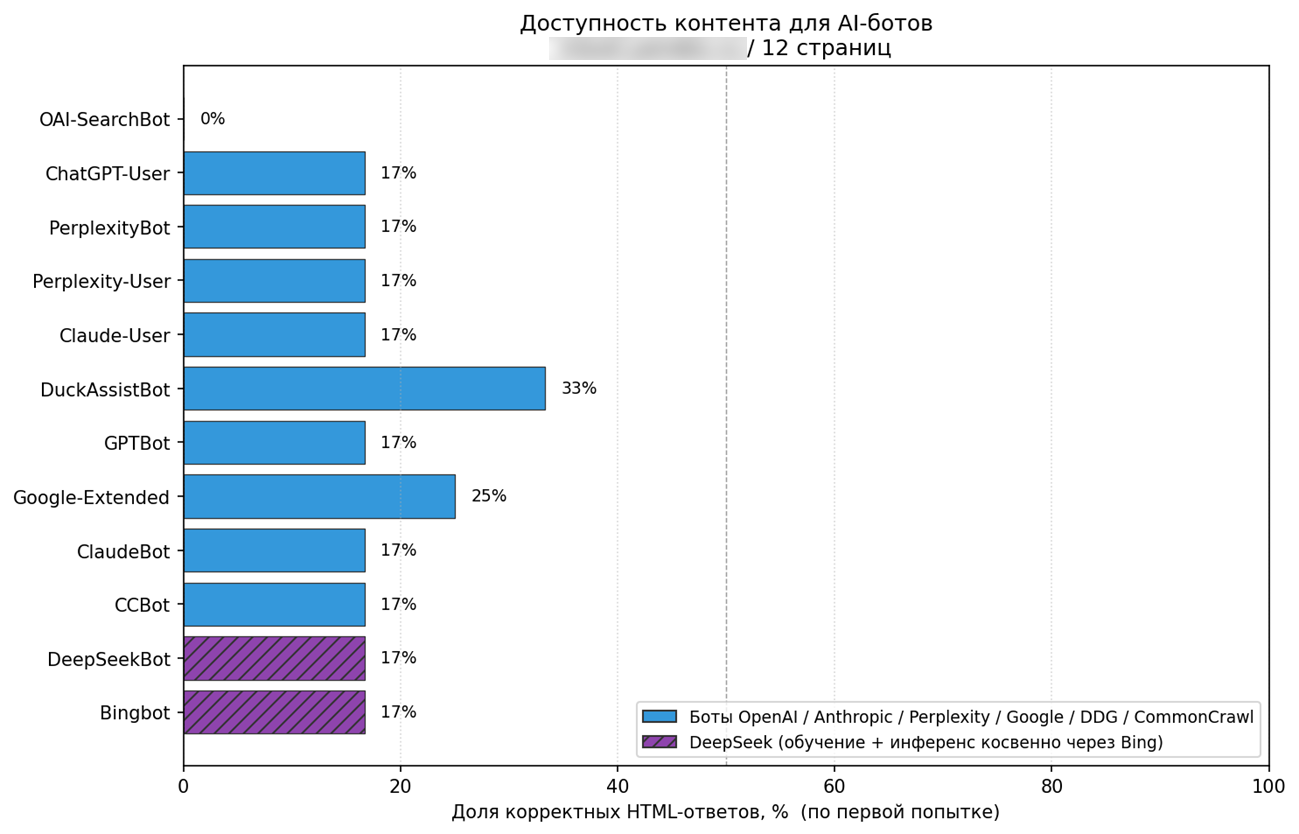
А Common Crawl при этом показывал картину, которую трудно назвать иначе как обманчивой: 4 813 записей, 4 799 уникальных URL, около 91% страниц со статусом 200.
Важно: данные Common Crawl и внешних чекеров не заменяют live-тест с User-Agent инференс-ботов на ваших коммерческих страницах.
Кейс 3. Медицинская сеть: 312 из 312 — полная доступность
Аудит региональной медицинской сети с несколькими доменами. Проверялись 26 URL и 12 ботов — всего 312 пар.
Все 312 получили стабильный OK/OK. Контентные страницы — 144 из 144 OK/OK. Технические URL — 168 из 168 OK/OK. Капчи, редиректы на защитные сценарии и ошибки формата не выявлены.
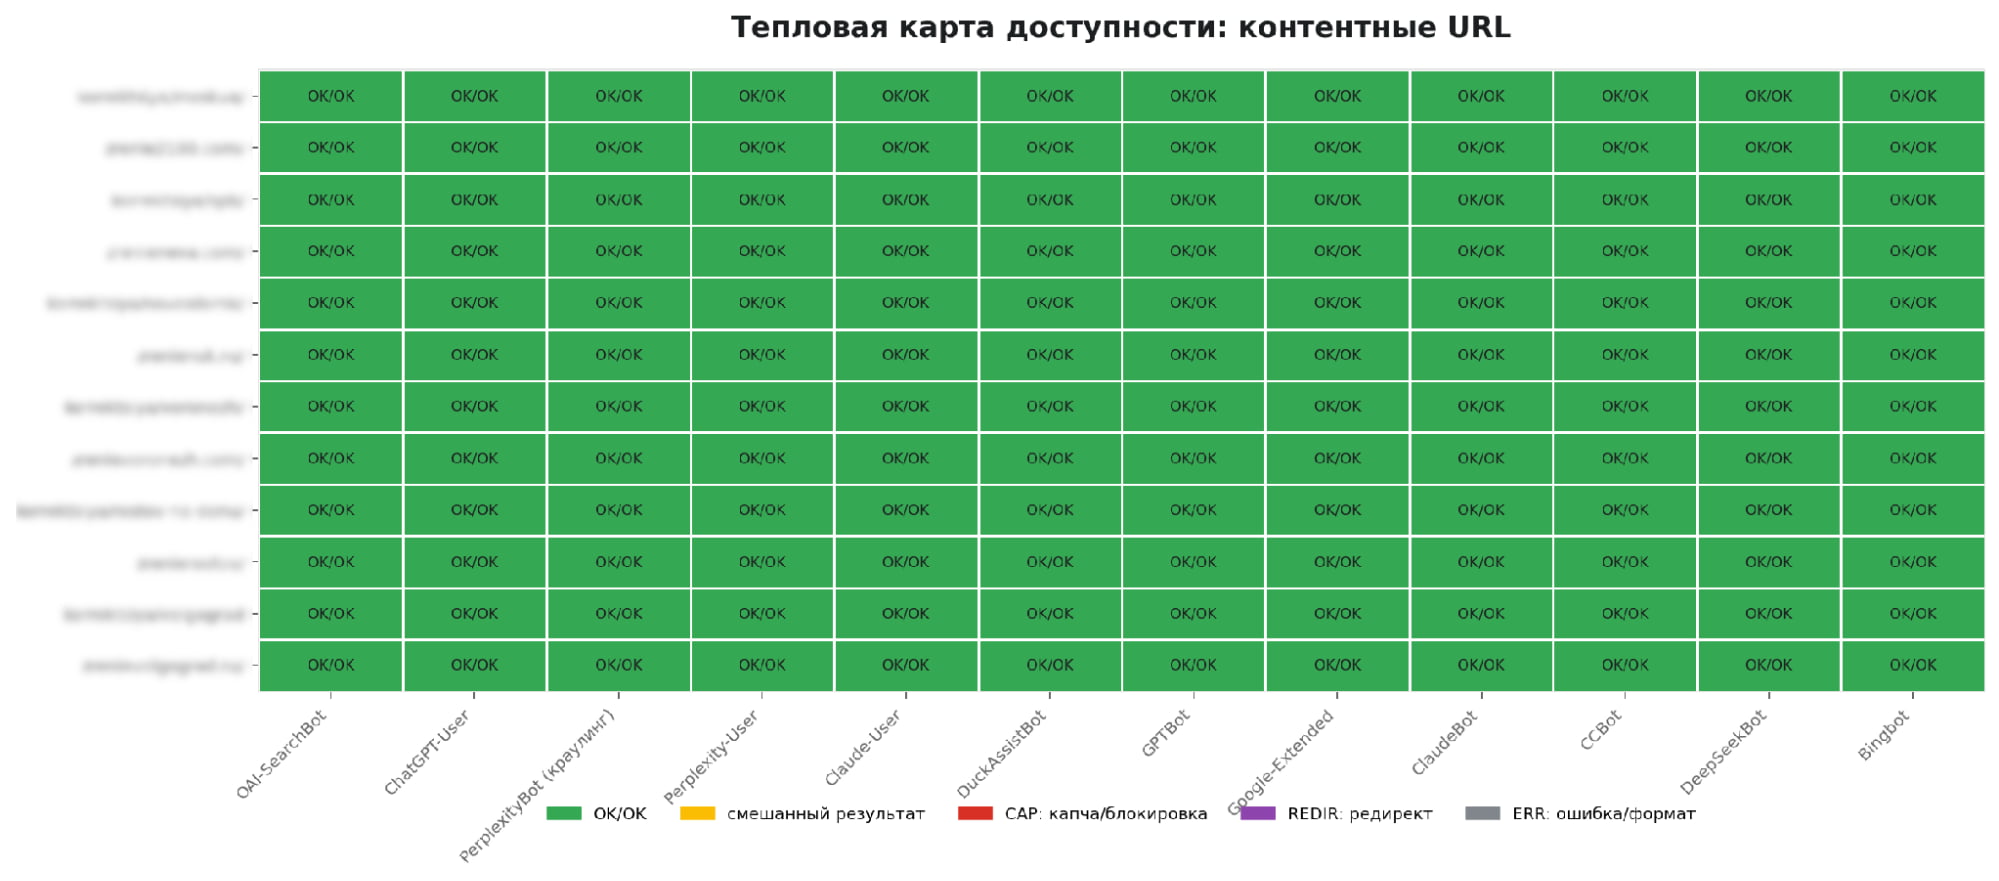
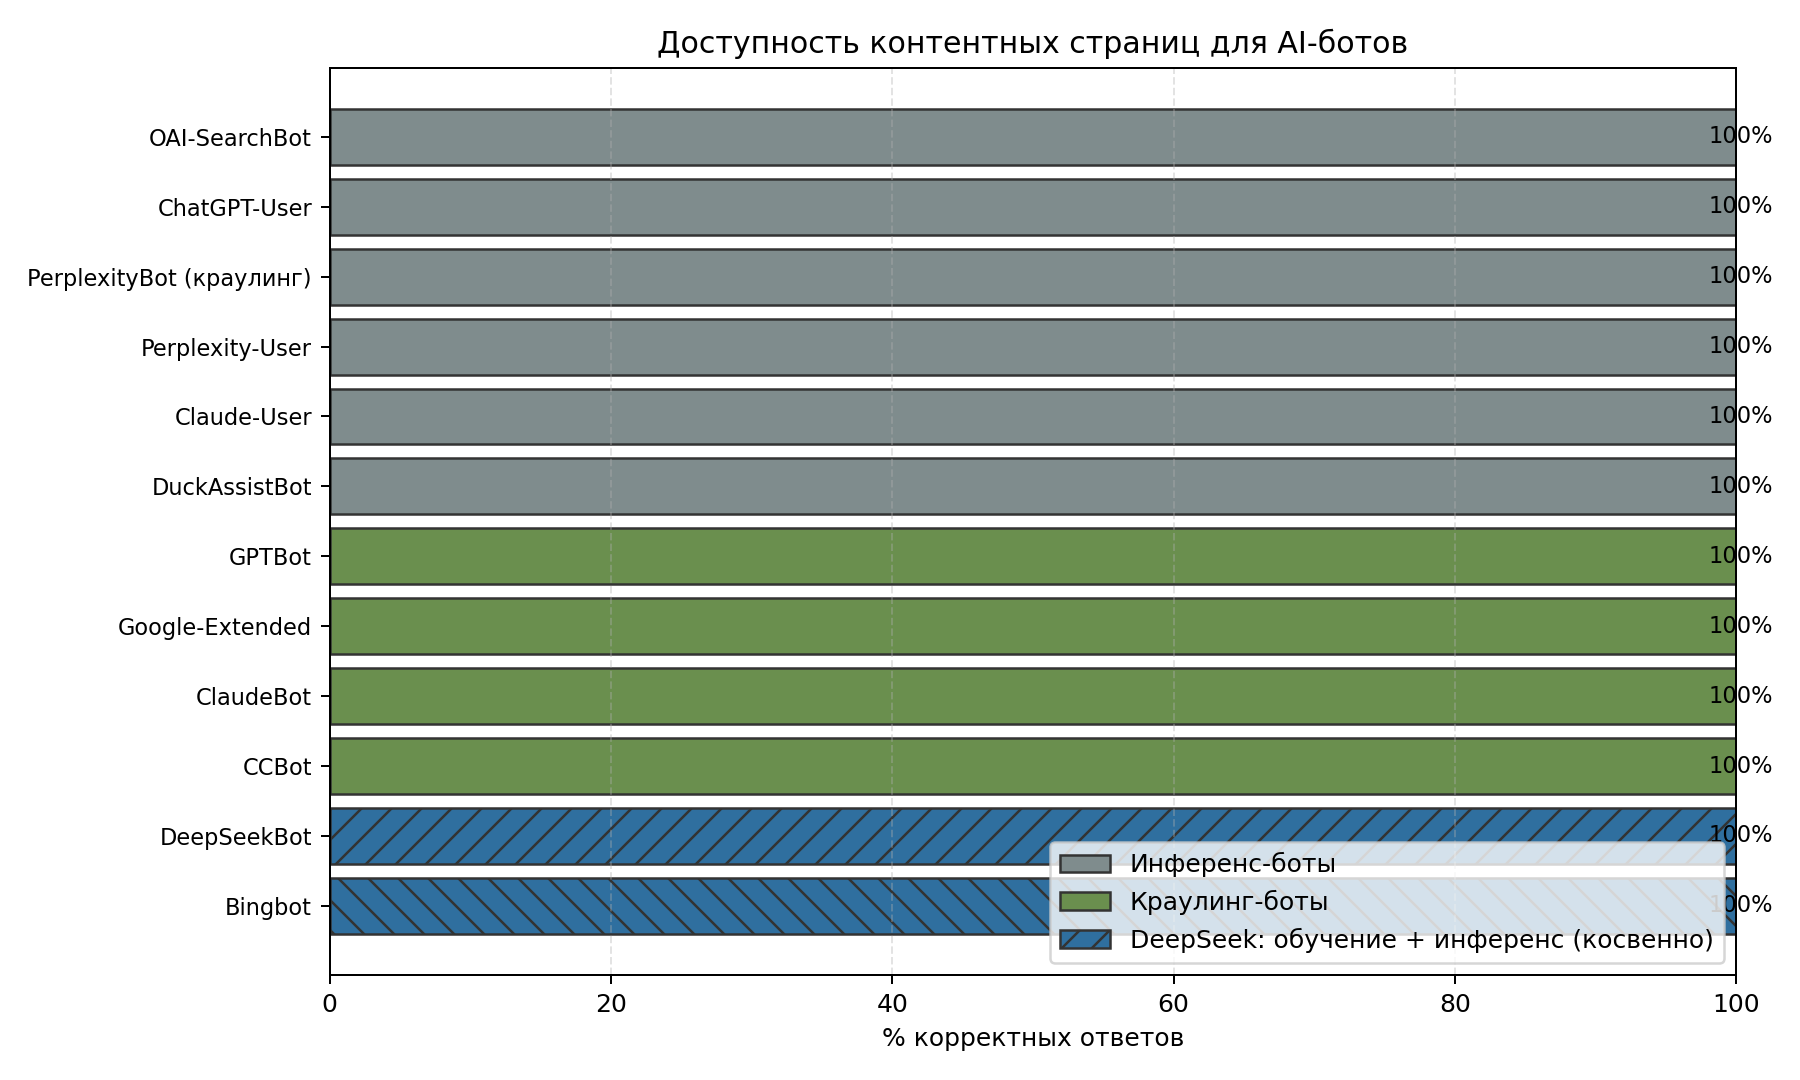
альт/подпись: Диаграмма доступности контентных страниц медицинской сети: 100% корректных ответов у каждого из 12 AI-ботов — инференс-ботов, краулеров и DeepSeek
Так выглядит хорошая базовая доступность: доверенные AI User-Agent получают полезный HTML, а не защитную заглушку. Этот кейс важен как контрольная точка — методика не «ищет блокировки любой ценой», она так же надежно фиксирует нормальную доступность.
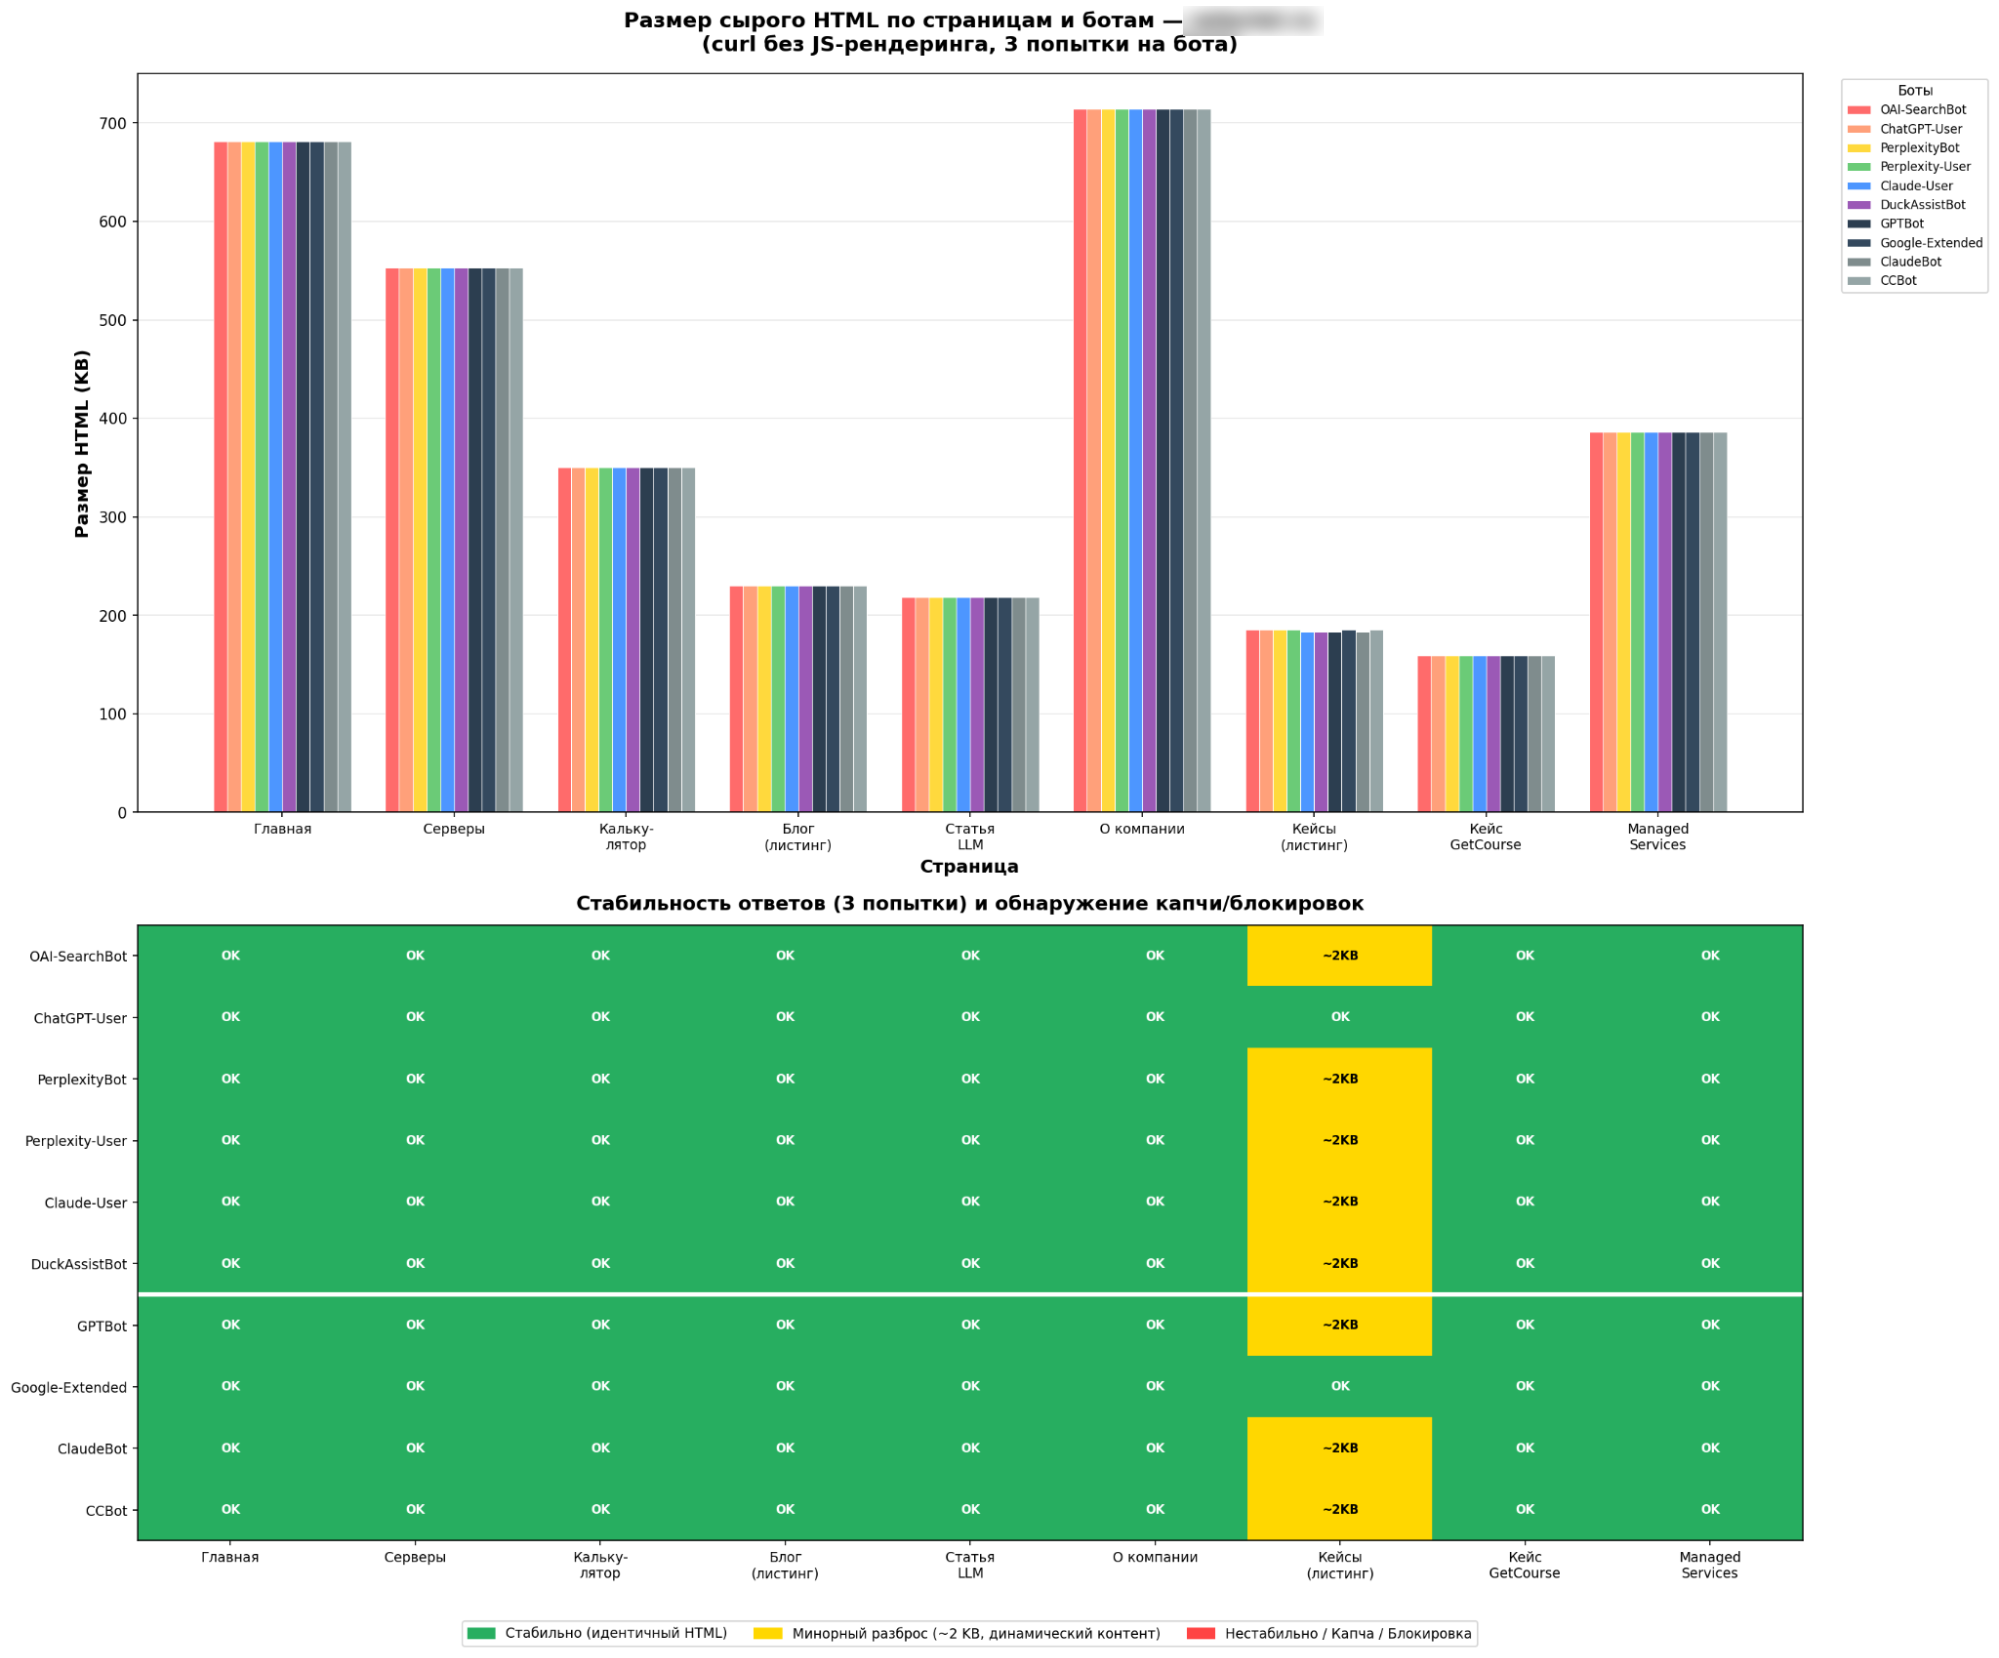
Похожую картину мы видели в раннем контрпримере: 10 ботов × 9 страниц × 3 попытки, 270 HTML-файлов. Все запросы вернули HTTP 200 с идентичным контентом, капча и DDoS-фильтры не срабатывали, сервер отдавал одинаковый HTML инференс-ботам и краулерам.
На практике: если после проверки вы получили картину, похожую на кейс 3, — это хорошая отправная точка, но не повод остановиться. Доступность — первое звено конвейера, дальше работают структура, контент и мониторинг. Если картина ближе к кейсам 1 или 2 — начинать нужно именно с доступности, и вот конкретный порядок действий.
Если узнали свою ситуацию в кейсах 1 или 2, напишите нам — мы проводим полный аудит AI-видимости по этой методологии.
Управление доступом — не клоакинг
Когда мы показываем результаты аудита и рекомендуем «обеспечить инференс-ботам доступ к коммерческим страницам», у технических специалистов иногда возникает вопрос: а это не клоакинг? Разведем два понятия, которые выглядят похоже, но устроены принципиально по-разному.
Клоакинг vs. снятие ложной блокировки
Клоакинг — это показ разного контента поисковому боту и пользователю: бот видит одну страницу, человек — другую. Цель — обмануть поисковую систему, показав ей контент, оптимизированный под ранжирование, которого пользователь никогда не увидит. Это нарушение правил поисковых систем, и мы его не рекомендуем.
Управление доступом для AI-ботов — другая задача. Речь о том, чтобы доверенный бот получил тот же публичный HTML, который уже доступен обычному пользователю без авторизации. Проблема возникает, когда защита сайта воспринимает AI User-Agent как подозрительный трафик и вместо публичной страницы отдает капчу. В таком случае бот не получает «особую версию» сайта — он не получает сайт вообще. Снять ложную блокировку — это не подмена контента, а устранение технической ошибки, из-за которой защита бьет по своим.
Например, у вас интернет-магазин мебели. Пользователь открывает каталог диванов и видит карточки, цены, описания, фильтры. Googlebot приходит — видит тот же HTML, индексирует. AI-бот приходит — получает SmartCaptcha. Задача — сделать так, чтобы AI-бот тоже увидел каталог диванов. Тот же каталог, что видит пользователь. Не специальную версию для ботов, не оптимизированный лендинг — тот же публичный HTML.
Матричная политика: не «открыть всех» и не «закрыть всех»
Частая ошибка — относиться ко всем AI-ботам одинаково. «Откройте всех AI-ботов» — слишком грубо: training-краулеры собирают данные для обучения моделей, и бизнес может иметь обоснованные причины ограничивать этот доступ. «Заблокируйте всех AI-ботов» — тоже слишком грубо: инференс-боты приходят по запросу пользователя, и их блокировка означает потерю видимости в AI-ответах.
Корректная настройка — матричная. Инференс-ботам (ChatGPT-User, Perplexity-User, Claude-User, OAI-SearchBot, DuckAssistBot) — обеспечить доступ к публичным коммерческим страницам без капчи, с верификацией через IP/reverse DNS. Краулерам (GPTBot, ClaudeBot, CCBot, Google-Extended, DeepSeekBot) — отдельная политика: разрешать, ограничивать по частоте, закрывать или открывать только определенные разделы — в зависимости от того, готов ли бизнес отдавать данные на обучение.
Верификация — ключевой элемент: не полагаться только на User-Agent, а проверять, что запрос приходит с официальных IP-диапазонов провайдера бота. Это защищает от спуфинга (когда парсер прикидывается GPTBot) и позволяет точечно управлять доступом. Документация провайдеров описывает, как это сделать: OpenAI публикует свои IP-диапазоны и рекомендации по верификации, Anthropic описывает механику своего краулера, Cloudflare разбирает типы AI-ботов и инструменты управления.
Порядок работ: доступность первична
Мы разобрали, что ломается и как это обнаружить. Теперь — что делать, если обнаружили проблему.
-
Проверить фактическую доступность. Отправить curl с User-Agent ключевых AI-ботов на 5–10 коммерчески значимых страниц (не только главную). Проверить тело ответа, а не только статус-код. Сравнить результаты между двумя попытками.
-
Настроить матричную политику доступа — разделить инференс-ботов и краулеров, настроить верификацию через IP/reverse DNS.
-
Переходить к структуре и контенту — schema.org, семантические блоки, E-E-A-T-сигналы.
-
Мониторить. Периодически повторять проверку доступности (антибот-правила могут измениться после обновления CDN/WAF) и отслеживать появление сайта в ответах AI-сервисов.
Проверьте в логах CDN/WAF: найдите запросы с User-Agent AI-ботов за последние 30 дней. Посмотрите, какие URL запрашивались, какие ответы получали, были ли срабатывания защиты. Если логи показывают массовые challenge/block для AI User-Agent на коммерческих страницах — это подтверждение того, что проблема реальна и влияет на видимость сайта в AI-ответах.
AI-видимость — это не отдельная задача из мира «будущего SEO». Это техническая задача на стыке SEO, CDN/WAF, антибот-защиты и серверного HTML, и решается она теми же инструментами, которые уже есть у технического SEO-специалиста или DevOps. Просто раньше никто не проверял, что именно получает AI-бот.
© Александра Ламонова, Senior SEO, специалист по GEO-оптимизации, moab
Главная мысль
Привычные инструменты проверки доступности проектировались для мира, где бот — это краулер поисковой системы, а доступность — это HTTP-статус. В мире, где бот — это AI-ассистент, обращающийся к сайту по запросу пользователя в реальном времени, проверять нужно не статус, а содержимое ответа.
Привычные инструменты — robots.txt, статус-коды, Common Crawl — могут показывать зеленый свет на сайте, где AI-боты получают капчу на каждой коммерческой странице.
Начните с одного действия: отправьте curl с User-Agent ChatGPT-User на три коммерчески значимые страницы вашего сайта и откройте сохраненный HTML. Если вместо контента — капча, дальше вы уже знаете, что делать.
Если нужна полная проверка по матрице — напишите нам.